网络运维可视化:企业需要看到什么
先明确业务目标与约束
可视化不是把图表堆满屏幕,先定三件事。业务类型决定看什么:外贸站群看目标站点访问成功率与时延,海外直播看上行抖动与丢包,AI 研发看大文件传输吞吐与稳定窗口。用户规模决定采样粒度:20 人以下按分钟级聚合即可,200 人以上必须支持单流溯源,否则故障定位只能靠猜。预算边界要把硬件、带宽、运维人力三项写清,可视化本身通常不单独计费,但原始流数据留存超过 30 天会带来存储成本。目标写成可验收的句子,例如「关键站点可用率不低于 99.5%,故障定位在 15 分钟内完成」,后续所有看板与告警都围绕这一句设计。
关键指标怎么看
带宽看两个数:峰值利用率与95 分位。峰值持续超过 70% 就该扩容或分流;95 分位长期贴近峰值说明负载持续偏高,扩容收益明确;明显低于峰值才是脉冲型,扩容收益低。延迟必须分段看——终端到接入节点、节点之间、节点到目标站点,只有超过 150ms 的那一段才需要处理,只看端到端总数无法定责。丢包比延迟更致命,1% 的丢包就可能让 TCP 吞吐掉三成,判断阈值建议:持续丢包高于 0.5% 视为异常,高于 2% 视为故障。抖动看 P95 与 P50 的差值,直播、语音场景超过 30ms 即告警。三个指标同屏呈现,只看带宽会漏掉小流量高丢包的链路。
方案对比
接入方式的选择本质是「终端可控」还是「链路可控」,两者可混用。对比时把三年总拥有成本算进去,其中停机损失往往大于硬件与订阅之和。终端分散、设备型号杂时优先客户端,办公点集中、需要双线切换时优先 CPE。
| 接入方式 | 部署周期 | 成本构成 | 适用规模 | 可视化深度 |
|---|---|---|---|---|
| 客户端(Windows/macOS/iOS/Android) | 1–3 天 | 订阅 + 运维人力 | 10–100 人 | 终端级,可定位单设备、单应用 |
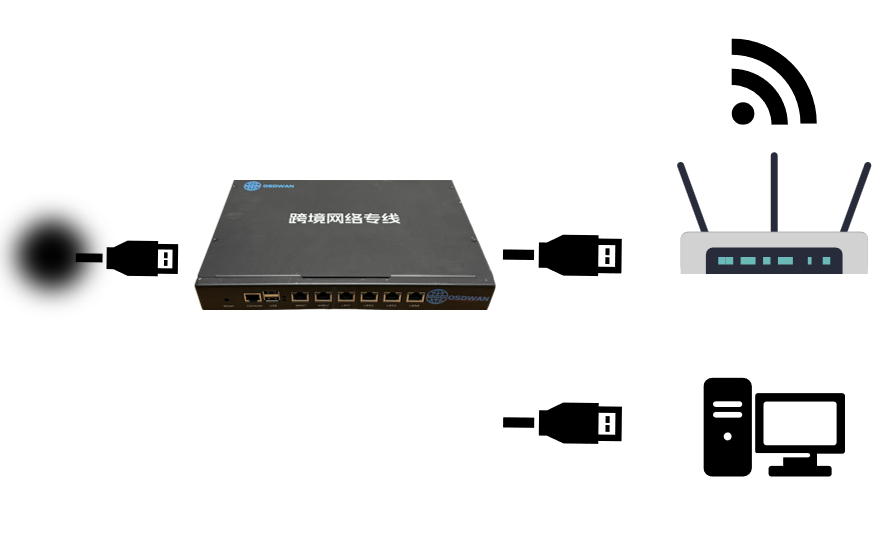
| CPE W1000A / W1000A-WiFi | 3–7 天 | 硬件 + 订阅 + 现场调试 | 单点 20–50 人 | 链路级,支持双线冗余与自动切换 |
| CPE W2000 | 1–2 周 | 硬件 + 订阅 + 带宽 | 单点 50–200 人 | 链路级 + 多 WAN 质量对比 |
| 客户端 + CPE 混合 | 1–2 周 | 以上相加 | 多分支企业 | 端到端,可打通终端与链路视图 |
分场景建议
- 小型(10–50 人):以客户端为主,主办公点放 1 台 W1000A。只做三张看板——链路可用率、延迟分位、异常终端 Top5。运维投入约 0.2 人,每周巡检一次。
- 中型(50–300 人):分支用 W1000A-WiFi 或 W2000,客户端补移动办公。要求每站点双线路、数据留存 30 天、告警接入企业微信或钉钉。阈值定在可用率 99.5%、丢包 0.5%。
- 大型(300 人以上):CPE 为主、客户端为辅,需要单流溯源与分应用质量视图,原始数据留存 90 天以上。建立值班表,P1 故障 15 分钟响应、2 小时内定位到跳段。
以上是通用思路,你的场景具体怎么配可以直接问顾问
落地步骤与常见问题
评估用 2 周:盘点现有链路、抓 7 天基线数据、列出最痛的 5 个故障场景。试点用 3–4 周:选 1 个分支加 10 个终端,跑满一个业务周期,重点验证告警准确率,误报超过 30% 就调阈值再上线。推广按站点分批,每批不超过 5 个点,每批结束做一次复盘并更新基线。常见问题有三个:只监控不定义基线,数据堆着没人看;阈值直接照抄设备默认值,误报淹没真故障;不留历史基线,出问题没有对比参照。排查顺序建议固定为:先确认单终端是否复现,再看接入节点状态,再看链路各跳段质量,最后核对目标站点可达性,逐层排除,不要一上来就换设备。
需要针对企业场景的组网方案?
扫码添加顾问微信
或拨打 400-0606-936 | 173-5717-8761